C++
&在等号左边是引用在右边是取地址
int &c = a; //声明变量a的一个引用c,c是变量a的一个别名,如果引用,声明的时候一定要初始化
使用引用传递(SqList &L),函数内部对 L 的修改会直接作用于实参,因为形参是实参的引用,二者指向同一块内存空间。
->与 .
| 操作 | 含义 | 优点 | 缺点 |
|---|---|---|---|
(*ptr_p1).age |
先解引用指针,再访问成员 | 语法基础,体现了操作的本质 | 写法繁琐,需要记住加括号 |
ptr_p1->age |
通过指针直接访问成员(语法糖) | 写法简洁、清晰、可读性极高 | 是一种抽象,隐藏了底层细节 |
结构体
struct tag {
    member-list
    member-list
    member-list
    ...
} variable-list ;
tag 是结构体标签。
member-list 是标准的变量定义,比如 int i; 或者 float f;,或者其他有效的变量定义。
variable-list 结构变量,定义在结构的末尾,最后一个分号之前,您可以指定一个或多个结构变量。下面是声明 Book 结构的方式:
struct Books
{
  char title[50];
  char author[50];
  char subject[100];
  int  book_id;
} book;
数据结构基本概念
数据:
数据元素:
数据对象:
对象是表,元素是行,项是列。
| 数据对象 | 同类数据的集合(同一类事物) | “学生表”“课程表”“成绩表” 等单个表格 |
|---|---|---|
| 数据元素 | 数据对象中的单个个体 | “学生表” 中的某一行记录(如张三的完整信息) |
| 数据项 | 数据元素的最小单位 | 某条记录中的一个字段值(如张三的学号 “2023001”) |
数据结构三要素
1.逻辑结构
指数据元素之间的逻辑关系
- 集合
- 线性结构
- 树形结构
- 图状结构或网状结构
2.物理结构
逻辑结构怎么在计算机中表示
- 顺序存储
- 链式存储
- 索引存储
- 散列存储
3.数据的运算
包括运算的定义和实现(在逻辑上说明做什么,在物理上说明怎么做)
运算的定义针对逻辑结构指出运算的功能(队头元素出队,新元素入队)
运算的实现针对物理结构,指出运算的具体操作步骤,对不同的物理结构(顺序,链式)运算的实现方式不同
算法
时间复杂度
T(n)为 时间开销其中n为问题规模
时间复杂度只是 “核心基本操作执行次数” 的增长趋势描述,不是一个具体的时间
T(n) = 3n+3(ms)
当时间开销很长如T1(n)=3n^3^+n^2^ +999999........我们只保留最高阶(因为后面的已经和最高阶不是一个量级的不影响结果)
我们用O(f(n)) 来表示T(n)的数量级,即f(n)为T(n)的最高阶,如T1(n),f(n)就为3n^3^表示为O(n^3^)
加法规则:T(n) = T1(n) + T2(n) = O(f(n)) + O(g(n)) = O(max(f(n),g(n))) 其中常数系数都标为1,如T1(n) = O(n^3^) + O(n^2^) +O(1)

T2(n) = n^3^+n^2^×log2n = O(n^3^)+O(n^2^log2n) =O(max(f(n),g(n))) 即判断n^3^与n^2^log2n 将n^3^看为n^2^×n 也就是比较log2n与n的大小根据上图n比log2n大所以T2(n)=O(n^3^)
对于一段程序不能把所有代码都分析一遍
1.顺序执行的代码(循环以外的代码)只影响常数项可以忽略
2.有多层循环的程序,只需关注其最深层的循环循环了几次
3.只需关注循环中的某一条即可
例1
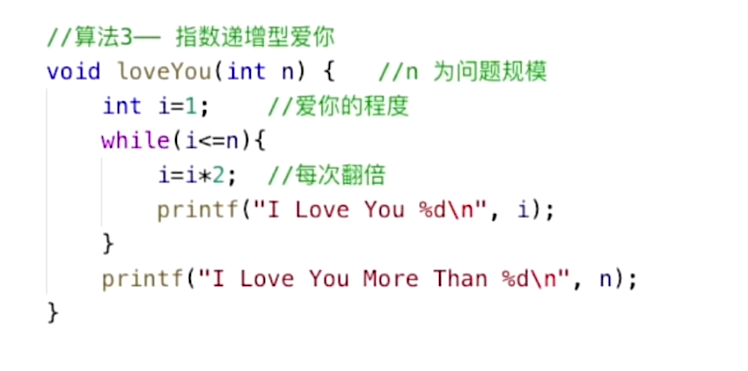
i = 2 , 4, 8 都为2的倍数也就是i=2^x^当2^x^>n时跳出循环,令2^x^ = n 即 x=log2n 即 x=log2n + 1时就比n要大根据加法规则答案就为O(log2n),
例2
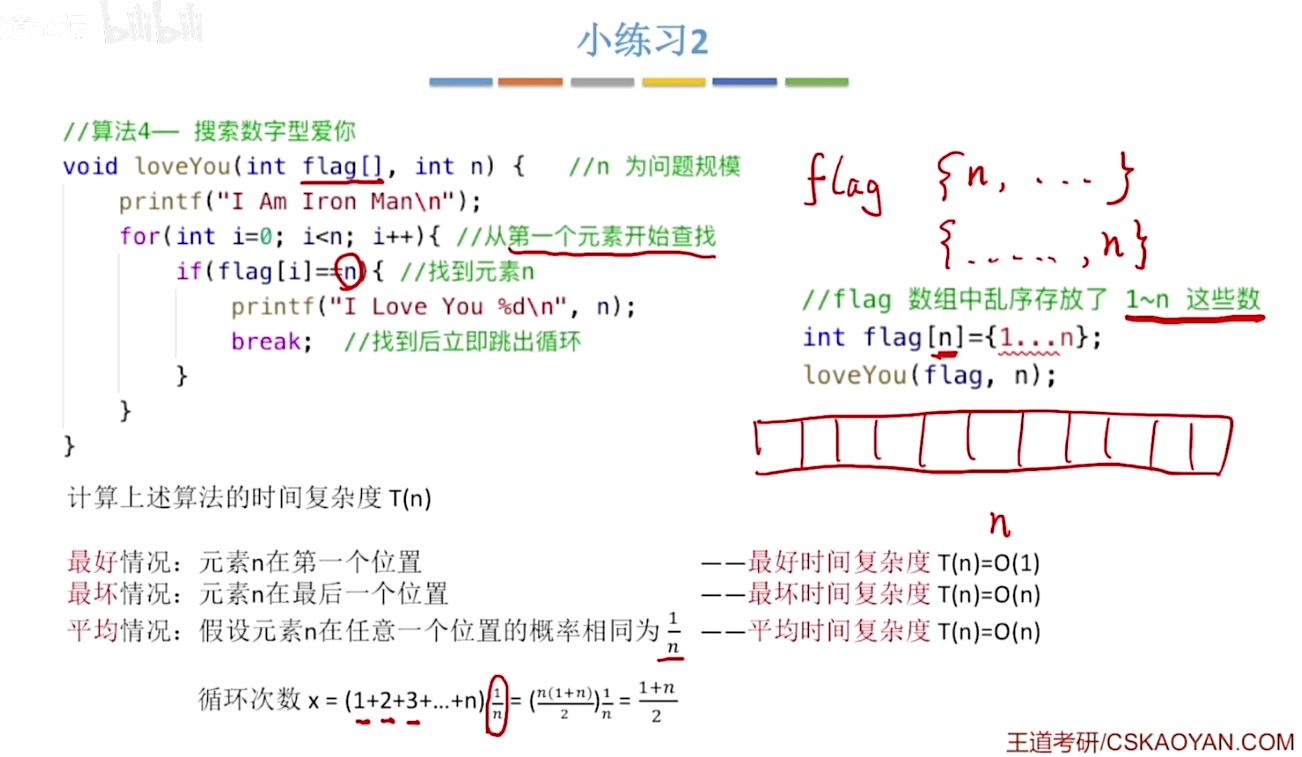
“所有可能情况的循环次数总和,乘以该元素在任意一个位置上的发生概率”
如果元素n出现在第一个位置循环次数就是1,出现在第二个位置循环次数就是2,出现在第n个位置循环次数就是n
所有可能的循环次数就是(1+2+3+4+...+n)
元素n出现在
因为 (1 + 2 + 3 + ....+ n) 是首项为 1、末项为 n、项数为 n 的等差数列,等差数列求和公式
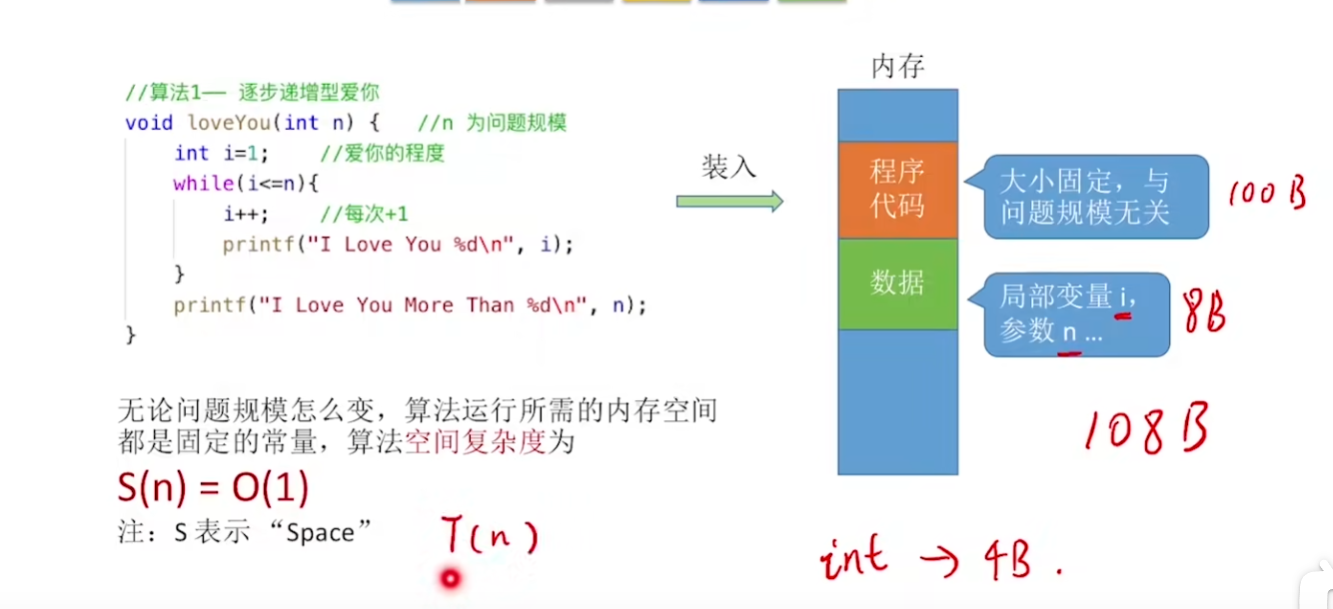
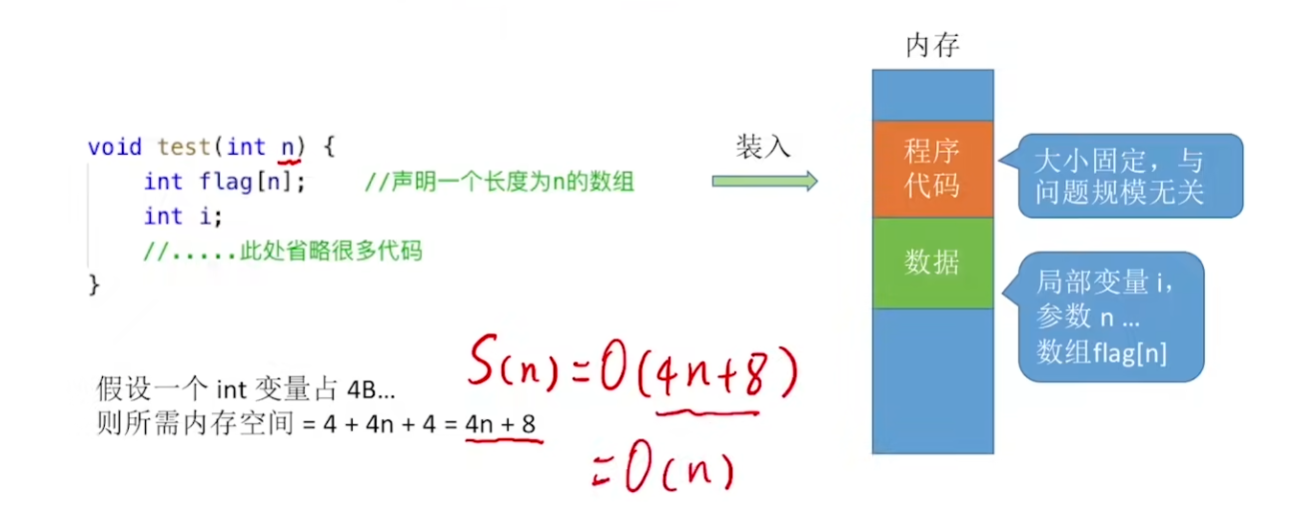
空间复杂度(space)
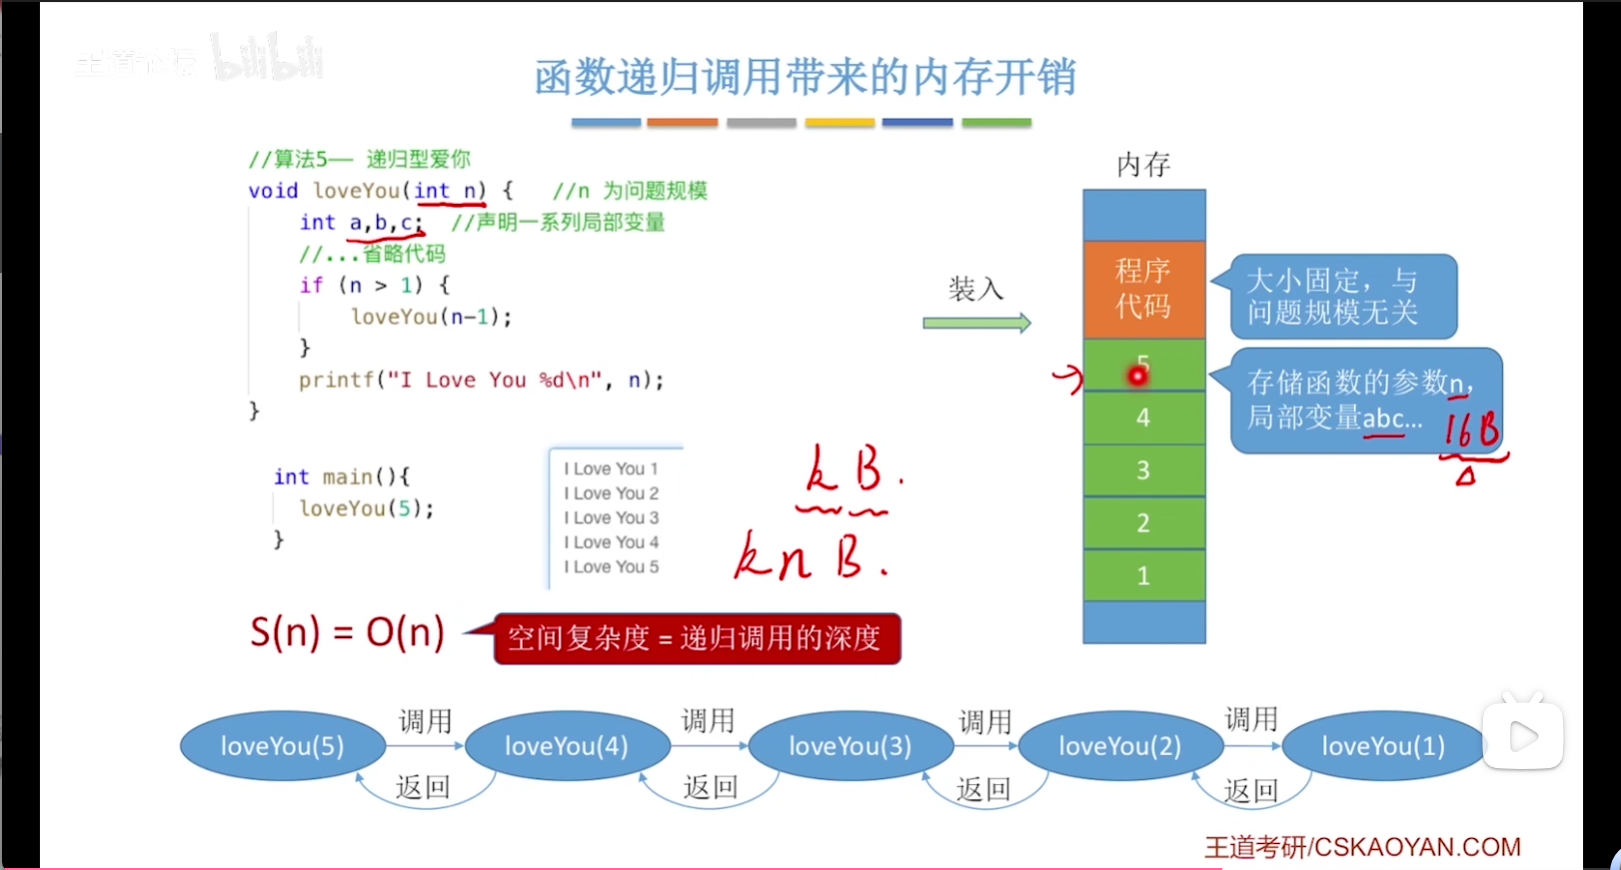
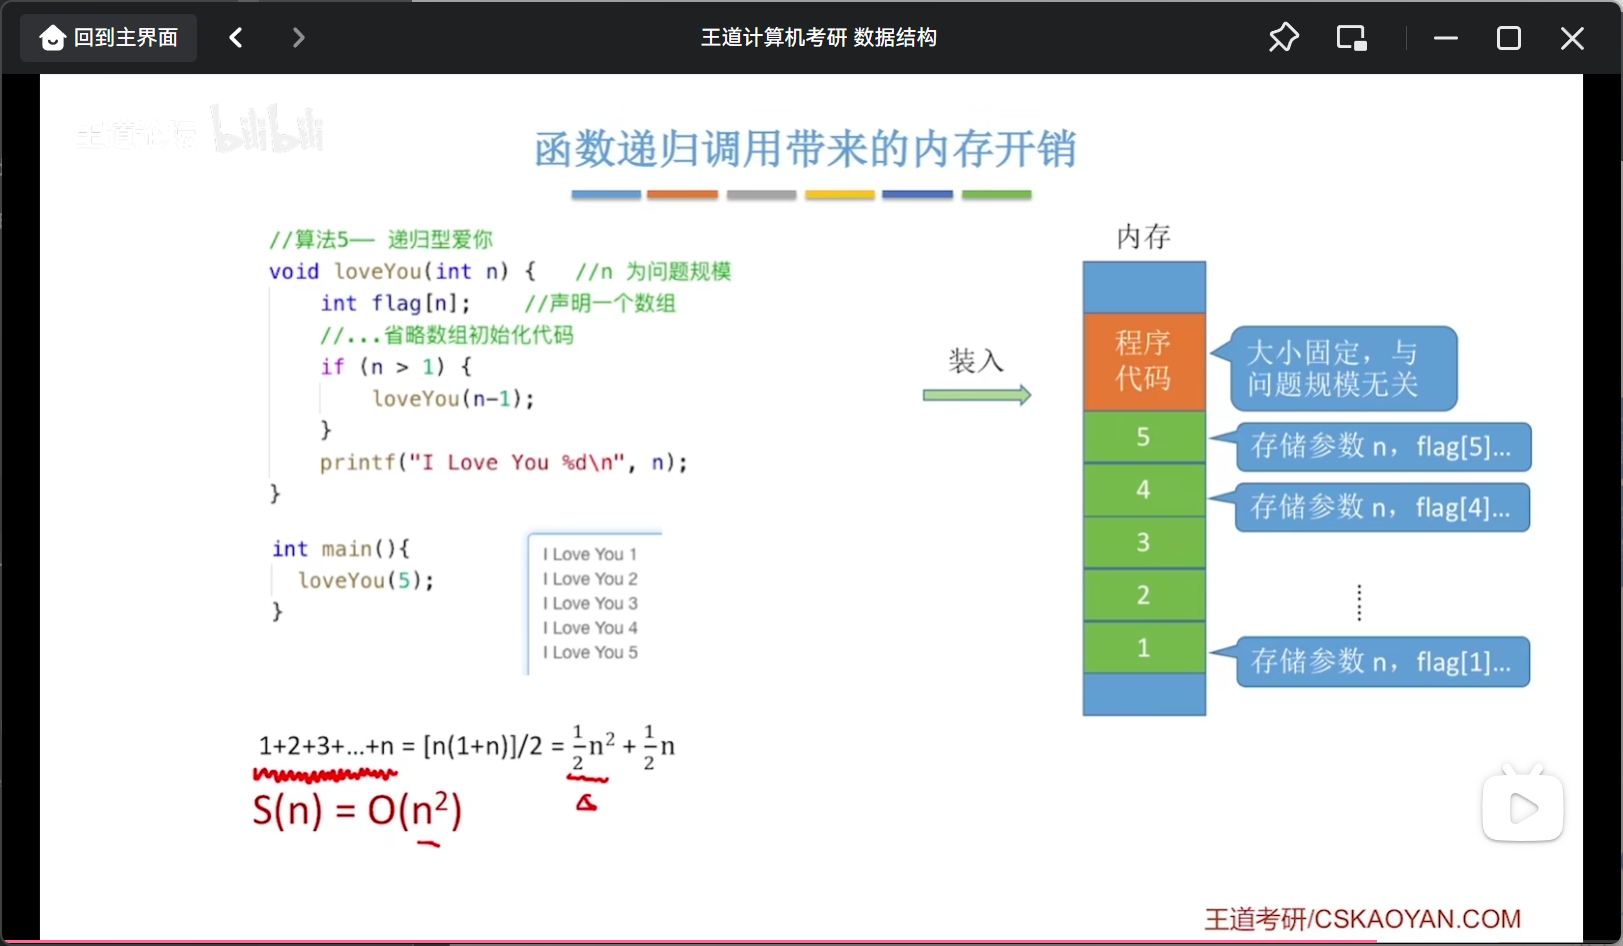
S(n) n同样表示问题规模,空间复杂度指的是空间开销与问题规模n之间的关系
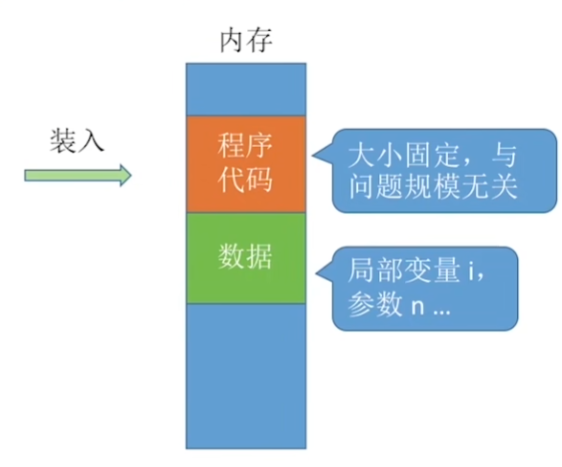
程序运行时占用内存的有程序代码以及程序需要的数据
计算空间复杂度只关注数据(也就是变量和参数所占用的空间)
例1
例2
例3
例4
时间复杂度题
等差数列求和公式首项为 a1、末项为 an、项数为 n 的等差数列,等差数列求和公式
等比数列求和公式 首项a 公比q 项数n(重点就是项数要用外层循环的次数)
先得出内层跑的次数(等差/等比/常数) 再看内层总体会跑多少次(也就是外层跑的次数)
递归题只要让算出的递归次数等于出口就行
例1
int sum=0;
for(int i=1;i<n;i*=2)
    for(int j = 0;j<i;j++)
        sum++;
直接看内层跑的次数,其中有一个次数的未知数,在外层循环求出后直接带入
外层循环跑2^x^=n时跳出循环,x=log2n也就是只跑log2n次
内层跑1 2 4 8 16 32 等比数列求和=2^x^-1;外层跑的次数带入内层得 2^log2n^ -1 等于n -1时间复杂度为O(n)
例2
for(i=n-1;i>1;i--)
    for(j=1;j<i;j++)
        if(A[j]>A[j+1])
            A[j]与A[j+1]互换
看出内层跑n-2 n-3 ... 1等差,首项是n-2 末项1 项数是外层的n-2 即结果为得O(n^2^)
外层假设n为5 i=4 , 3 , 2 一共跑三次也就是 n-2
例3
int Func(int n){
    if(n==1) return 1;
    else return 2*Func(n/2)+n
}
递归次数=n/2^k^让它==1(递归出口) 结果K=log2n
线性表
- **线性表:逻辑结构, 就是对外暴露数据之间的关系,不关心底层如何实现,数据结构的逻辑结构大分类就是线性结构和非线性结构而顺序表、链表都是一种线性表。
- 顺序表、链表:物理结构,他是实现一个结构实际物理地址上的结构。比如顺序表就是用数组实现。而链表用指针完成主要工作。不同的结构在不同的场景有不同的区别。
顺序表
顺序表的特点:
1.随机访问(O(1)时间找到第i个)
2.存储密度高,每个节点只存储数据元素本身(链式存储还需要存储链接的下一个元素的地址)
3.拓展容量不方便(动态分配拓展长度的时间复杂度高)
4.插入,删除操作不方便
静态分配
为什么要初始化数组
1.因为分配给结构体中的内存地址可能有之前遗留的数据(脏数据)
2.初始化长度为0也非常重要
#include <stdio.h>
#define MaxSize 10      //定义最大长度
typedef struct{
    int data[MaxSize];//用静态的“数组”存放数据元素
    int length;       //顺序表的当前长度
}SqList;              //顺序表的类型定义

//基本操作—初始化一个顺序表
void InitList(SqList &L){
    for(int i=0; i<MaxSize; i++)
        L.data[i]=0;   //将所有数据元素设置为默认初始值
    L.length=0;        //顺序表初始长度为0
}

int main() {
    SqList L;          //声明一个顺序表
    InitList(L);       //初始化顺序表
    //后续操作
    return 0;
}
动态分配
#include "stdlib.h"
#define InitSize 10
typedef struct{
    int *data,
    int MaxSize,length //数组最大容量,当前个数
}SeqList

void InitList(SeqList &L){
    L.data = (int*) malloc(sizeof(int) * InitSize);
    L.length=0;
    L.MaxSize=InitSize;
}

//动态增加数组长度
void IncreaseSize(SeqList &L,int len){
    int *p = L.data;
    L.data = (int *) malloc((L.MaxSize +len ) * sizeof(int));
    for(int i=0; i<L.length; i++){
        L.data[i]=p[i]; //将数据复制到新区域
    }
    L.MaxSize = L.MaxSize + len;
    free(p)
}


int main(){
    SeqList L;
    InitList(L);
    //这里省略插入几个元素
    IncreaseSize(L,5);
    return 0;
}
L.data = (ElementType*) malloc(sizeof(ElemType) * InitSize);
malloc返回分配空间的首地址默认void * 类型需要强转为对应类型(让编译器知道怎么处理)
    	malloc 返回的只是首地址,用户需要记录MaxSize在操作中防止越界
sizeof(ElemType) 类型的字节数 * 要分配的个数 就等于 总字节数
free() 能精准释放内存是因为malloc分配时会额外有一个内存控制块在分配空间的前N个字节,用于存储一些元信息,free()会找到首地址向前N个字节找到元信息然后释放空间
插入操作
//注意i是位序
#define MaxSize 10       // 定义最大长度
typedef struct{
    int data[MaxSize];   // 用静态的“数组”存放数据元素
    int length;          // 顺序表的当前长度
}SqList;                // 顺序表的类型定义

bool ListInsert(SqList &L, int i, int e){
    if(i<1 || i>L.length+1)       // 判断i的范围是否有效
        return false;
    if(L.length>=MaxSize)         // 当前存储空间已满,不能插入
        return false;
    for(int j=L.length; j>=i; j--)  // 将第i个元素及之后的元素后移
        L.data[j] = L.data[j-1];
    L.data[i-1] = e;              // 在位置i处放入e
    L.length++;                   // 长度加1
    return true;
}
该程序的平均时间复杂度
n为L.length
1.假设新元素插入到任何一个位置概率相同,i=1,2,3,4,5.....,length+1的概率都是p=
2.平均循环次数=总移动次数×单个概率()×=n/2 = O(n)
总移动次数=如果i移动n次,i=2移动n-1次 i = n+1 移动0次,就是1+2+3+...+n,等差数列求和
最坏情况在表头插入i=1,元素后移将执行n次
最好情况在表末尾插入,无需移动时间复杂度O(1)
删除操作
最好情况在表末尾删除无需移动时间复杂度O(1)
最坏情况在表头删除,元素前移将执行n-1次
平均时间复杂度:
1.概率相同但与插入不同的是i=1,2,3,4,5....n的j概率都是1/n
2.)×=O(n)
bool ListDelete(SqList &L, int i, int &e) {
    if (i < 1 || i > L.length)           // 判断i的范围是否有效
        return false;
    e = L.data[i - 1];                   // 将被删除的元素赋值给e
    for (int j = i; j < L.length; j++)   // 将第i个位置后的元素前移
        L.data[j - 1] = L.data[j];
    L.length--;                          // 线性表长度减1
    return true;
}

int main() {
    SqList L;          // 声明一个顺序表
    InitList(L);       // 初始化顺序表
    //...此处省略一些代码,插入几个元素
    int e = -1;        // 用变量e把删除的元素“带回来”
    if (ListDelete(L, 3, e))
        printf("已删除第3个元素,删除元素值为=%d\n", e);
    else
        printf("位序i不合法,删除失败\n");
    return 0;
}
按值查找
typedef struct{
    int *data;      //指示动态分配数组的指针
    int MaxSize;    //顺序表的最大容量
    int length;     //顺序表的当前长度
}SeqList;

//在顺序表L中查找第一个元素值等于e的元素,并返回其位序
int LocateElem(SeqList L,int e){
    for(int i=0;i<L.length;i++)
        if(L.data[i]==e)
            return i+1; //返回其位序
    return 0;
}
结构体不能直接用==比较,需要判断结构体内部的所有成员来判断两个结构体是否相等
typedef struct {
    int num;
    int people;
} Customer;

void test() {
    Customer a;
    a.num = 1;
    a.people = 1;
    Customer b;
    b.num = 1;
    b.people = 1;
    if (a == b) {    //Invalid operands to binary expression ('Customer' and 'Customer')
        printf("相等");
    } else {
        printf("不相等");
    }
}
bool isCustomerEqual (Customer a, Customer b){
    if (a.num == b.num && a.people == b.people)
        return true;
    else
        return false;
}
结构体标签问题问题
//此时的LNode是标签,这里用标签就是为了在结构体内部嵌套它本身
struct LNode {
    int data;
    struct LNode* next;  // 正确:struct + 标签 = 完整类型
};

// 外部使用时:
struct LNode node1;  // 正确:struct + 标签 定义变量
// LNode node2;       // 错误:单独用标签不能定义变量
typedef struct LNode{
    ElemType data;           // 每个节点存放一个数据元素
    struct LNode *next;      // 指针指向下一个节点
}LNode, *LinkList;           // 定义单链表结点类型


此时的最外层的LNode 代表 struct LNode
*LinkList代表 struct LNode *
单链表
对于每一个单链表除了存储数据外,还需存储一个指向后继的指针
LNode:是struct LNode的别名,代表单个节点的类型(包含数据和指针)。LinkList:是struct LNode*的别名,代表链表,在语义上是整个链表的头指针。当涉及 “整个链表”(如传递头指针、初始化链表),用LinkList;- 当涉及 “整个链表”(如传递头指针、初始化链表),用
LinkList; - 当涉及 “单个节点”(如返回某节点、操作节点内数据),用
LNode* - 单链表每一个节点都是一步一步用malloc创建出来的
通常我们用 Lnode * 来存一个单个节点的首地址
用LinkList 来标识一个链表实际上他俩是一个东西的类型是相同的,LinkList 存的是头节点的首地址(无头节点即第一个节点的首地址)
当需要在函数内部改变头指针变量(L)本身的值时(即让它指向一个新的节点或 NULL),就必须使用引用传递(&)所以带头结点的链表基本不需要带引用传递
//按查找节点
typedef struct LNode{
    ElemType data;           // 每个节点存放一个数据元素
    struct LNode *next;      // 指针指向下一个节点
}LNode, *LinkList;           // 定义单链表结点类型

LNode* GetElem(LinkList L, int i){
    int j=1;
    LNode *p=L->next; //让p指向第一个节点
    if(i==0)
        return L;
    if(i<1)
        return NULL;
    while(p!=NULL && j<i){
        p=p->next;
        j++;
    }
    return p;
}
单链表分为带头节点的链表和不带头节点的链表,头节点即用一个节点再所有结点之前,该节点data无意义只是存储一个指向第一个节点的地址,用struct LNode *来表示,而不带头节点链表struct LNode *就表示第一个节点,所以带头节点的和不带头节点的链表操作上有不同,
带头节点的链表在插入到链头时无需处理空链表特殊情况,逻辑更统一,推荐优先使用。
插入表头
带头节点链表
#include <stdio.h>
#include <stdlib.h>

// 1. 定义节点类型
typedef struct LNode {
    int data;               // 数据域(存储整数)
    struct LNode* next;     // 指针域(指向下一节点)
} LNode, *LinkList;

// 2. 初始化带头节点的链表
// 功能:创建头节点,初始化为空链表(头节点next=NULL)
bool InitListWithHead(LinkList& L) {
    L = (LNode*)malloc(sizeof(LNode));  // 分配头节点内存
    if (L == NULL) {
        printf("初始化失败(内存不足)\n");
        return false;
    }
    L->next = NULL;  // 头节点的next置空(空链表标志)
    printf("带头节点的链表初始化成功\n");
    return true;
}

// 3. 向链表插入数据(在表头插入,演示传值)
// 功能:将值e插入到链表的第一个位置
void InsertDataWithHead(LinkList L, int e) {
    // 创建新节点并传值
    LNode* newNode = (LNode*)malloc(sizeof(LNode));
    newNode->data = e;  // 传入数据e到新节点

    // 插入到表头(头节点之后)
    newNode->next = L->next;  // 新节点指向原第一个数据节点
    L->next = newNode;        // 头节点指向新节点
    printf("插入数据:%d\n", e);
}

int main() {
    LinkList L;  // 定义头指针

    // 初始化
    if (!InitListWithHead(L)) {
        return 1;  // 初始化失败则退出
    }

    // 插入数据(传值示例)
    InsertDataWithHead(L, 10);  // 插入10

}
不带头节点的链表
#include <stdio.h>
#include <stdlib.h>

// 1. 定义节点类型(与带头节点相同)
typedef struct LNode {
    int data;
    struct LNode* next;
} LNode, *LinkList;

// 2. 初始化不带头节点的链表
// 功能:头指针直接置空(空链表标志)
bool InitListWithoutHead(LinkList& L) {
    L = NULL;  // 空链表时头指针为NULL
    printf("不带头节点的链表初始化成功\n");
    return true;
}

// 3. 向链表插入数据(在表头插入,演示传值)
// 功能:将值e插入到链表的第一个位置(需特殊处理空链表)
void InsertDataWithoutHead(LinkList& L, int e) {
    // 创建新节点并传值
    LNode* newNode = (LNode*)malloc(sizeof(LNode));
    newNode->data = e;  // 传入数据e到新节点

    // 插入到表头(需判断是否为空链表)
    if (L == NULL) {  // 空链表时,新节点就是第一个节点
        newNode->next = NULL;
        L = newNode;  // 头指针直接指向新节点
    } else {  // 非空链表时,新节点指向原第一个节点
        newNode->next = L;
        L = newNode;  // 头指针更新为新节点
    }
    printf("插入数据:%d\n", e);
}

int main() {
    LinkList L;  // 定义头指针

    // 初始化
    InitListWithoutHead(L);

    // 插入数据(传值示例)
    InsertDataWithoutHead(L, 10);  // 插入10(空链表情况)
}
可以看到在InsertData操作时没有带头节点的使用了引用,而带头节点的没有使用引用,这是因为不带头节点的需要修改其本身的地址,而带头节点的只需要修改其next属性,传递时虽然是L的复制品,但是复制品L中保存的地址仍然是L的实际内存位置,所以可以修改其中的next属性,但是无法修改本身的地址
这里需要理解指针变量也是变量,他也会占用一定的空间,只不过他内部存储的是其他变量在内存中的地址
按位序插入
思路:找到该位序的前驱节点在前驱节点之后插入节点,将前驱节点的next赋值给新节点next将链表重新链起来
不带头节点的链表因为第一个元素没有前驱节点所以需修改其头节点就是让新节点当头节点,将原来头节点地址本身给新节点next,将表重新链上
带头节点
typedef struct LNode{
    ElemType data;     // 数据域,存储元素类型为 ElemType
    struct LNode *next; // 指针域,指向下一个结点
} LNode, *LinkList;

// 在第 i 个位置插入元素 e(带头结点)
bool ListInsert(LinkList &L, int i, ElemType e) {
    // 步骤1:检查插入位置合法性
    if (i < 1)
        return false;

    // 步骤2:初始化扫描指针 p 和计数器 j
    LNode *p;   // 用于扫描链表的指针
    int j = 0;  // 记录 p 当前指向的是“第几个结点”(头结点是第 0 个)
    p = L;      // p 先指向“头结点”(头结点不存有效数据,是第 0 个结点)

    // 步骤3:循环找到“第 i-1 个结点”(插入位置的前驱结点)
    while (p != NULL && j < i-1) {
        p = p->next; // p 向后扫描
        j++;         // 计数器递增
    }

    // 步骤4:检查 i 是否合法(p 为 NULL 说明 i 超出链表长度+1)
    if (p == NULL)
        return false;

    // 步骤5:创建新结点 s 并初始化
    LNode *s = (LNode *)malloc(sizeof(LNode)); // 分配新结点内存
    s->data = e; // 新结点数据域赋值为 e

    // 步骤6:完成插入(先连后继,再连前驱)
    s->next = p->next; // 新结点 s 的 next 指向 p 原来的后继
    p->next = s;       // p 的 next 指向新结点 s

    return true; // 插入成功
}


///自己写的版本
bool ListInsert(LinkList L, int i, ElemType e) {
   if (i < 1)
        return false;

  Lnode *p = L;
  for(int j=1;j<i;j++){
    p=p->next;
    if (p == NULL)
    return false;
  }

  Lnode *newnode = (Lnode*) malloc(sizeof(Lnode));
  if (newnode == NULL)
    return false; // 内存不足
  newnode->data = e;
  newnode->next = p->next;
  p->next = newnode;
  return true;

}
不带头节点
typedef struct LNode{
    ElemType data;     // 数据域,存储元素类型为 ElemType
    struct LNode *next; // 指针域,指向下一个结点
} LNode, *LinkList;

bool ListInsert(LinkList &L, int i, ElemType e) {
    // 步骤1:检查插入位置合法性(位序 i 不能小于1)
    if (i < 1)
        return false;

    // 步骤2:处理“插入到第1个位置”的特殊情况(需修改头指针 L)
    if (i == 1) {
        LNode *s = (LNode *)malloc(sizeof(LNode)); // 分配新结点内存
        s->data = e;                               // 新结点数据域赋值为 e
        s->next = L;                               // 新结点的 next 指向原头指针 L(原第一个结点)
        L = s;                                     // 头指针 L 重新指向新结点(新结点成为第一个结点)
        return true;                               // 插入成功
    }

    // 步骤3:处理“插入到其他位置”的情况(需先找到第 i-1 个结点)
    LNode *p;   // 用于扫描链表的指针
    int j = 1;  // 记录 p 当前指向的是“第几个结点”(从第1个开始)
    p = L;      // p 先指向“第1个结点”(不带头结点,L 直接指向第一个有效结点)

    // 循环找到“第 i-1 个结点”(插入位置的前驱结点)
    while (p != NULL && j < i-1) {
        p = p->next; // p 向后扫描
        j++;         // 计数器递增
    }

    // 步骤4:检查 i 是否合法(p 为 NULL 说明 i 超出链表长度+1)
    if (p == NULL)
        return false;

    // 步骤5:创建新结点 s 并初始化
    LNode *s = (LNode *)malloc(sizeof(LNode)); // 分配新结点内存
    s->data = e; // 新结点数据域赋值为 e

    // 步骤6:完成插入(先连后继,再连前驱)
    s->next = p->next; // 新结点 s 的 next 指向 p 原来的后继
    p->next = s;       // p 的 next 指向新结点 s

    return true; // 插入成功
}
封装
typedef struct LNode{
    ElemType data;     // 数据域,存储元素类型为 ElemType
    struct LNode *next; // 指针域,指向下一个结点
} LNode, *LinkList;

// 在第 i 个位置插入元素 e(带头结点)
bool ListInsert(LinkList &L, int i, ElemType e) {
    // 步骤1:检查插入位置合法性
    if (i < 1)
        return false;

    // 步骤2:初始化扫描指针 p 和计数器 j
    LNode *p;   // 用于扫描链表的指针
    int j = 0;  // 记录 p 当前指向的是“第几个结点”(头结点是第 0 个)
    p = L;      // p 先指向“头结点”

    // 步骤3:循环找到“第 i-1 个结点”(插入位置的前驱结点)
    while (p != NULL && j < i-1) {
        p = p->next; // p 向后扫描
        j++;         // 计数器递增
    }

    // 步骤4:检查 i 是否合法(并调用后插函数完成插入)
    if (p == NULL)
        return false; // i 超出范围,插入失败
    else
        return InsertNextNode(p, e); // 调用“后插函数”,在 p 后插入 e
}


// 后插操作:在结点 p 之后插入元素 e
bool InsertNextNode(LNode *p, ElemType e) {
    // 步骤1:检查 p 是否合法(p 为 NULL 则无法插入)
    if (p == NULL)
        return false;

    // 步骤2:分配新结点内存
    LNode *s = (LNode *)malloc(sizeof(LNode));
    if (s == NULL)     // 内存分配失败
        return false;

    // 步骤3:初始化新结点并完成插入
    s->data = e;         // 新结点数据域赋值为 e
    s->next = p->next;   // 新结点的 next 指向 p 原来的后继
    p->next = s;         // p 的 next 指向新结点 s

    return true; // 插入成功
}
指定节点的前插操作
由于单链表的特性只保存next(下一个节点的地址),前插操作就需要用下面的方式(先后插然后换数据,逻辑上是一样的时间复杂度为O(n)),也可使使用头指针循环到该节点的前驱节点进行后插但时间复杂度为O(n)
// 前插操作:在 p 结点之前插入元素 e
bool InsertPriorNode(LNode *p, ElemType e) {
    // 如果 p 是 NULL,无法进行前插操作,返回 false
    if (p == NULL)
        return false;
    // 分配新结点 s 的内存空间
    LNode *s = (LNode *)malloc(sizeof(LNode));
    // 如果内存分配失败,返回 false
    if (s == NULL)     // 内存分配失败
        return false;
    // 新结点 s 的 next 指针指向 p 原来的 next 指针指向的结点
    s->next = p->next;
    // p 的 next 指针指向新结点 s,此时 s 连到了 p 之后
    p->next = s;
    // 将 p 中的元素复制到新结点 s 的数据域中
    s->data = p->data;
    // 将 p 中的元素覆盖为要插入的元素 e
    p->data = e;
    // 前插操作成功,返回 true
    return true;
}
按位序删除
typedef struct LNode{
    ElemType data;     // 数据域,存储元素类型为 ElemType
    struct LNode *next; // 指针域,指向下一个结点
} LNode, *LinkList;

bool ListDelete(LinkList &L, int i, ElemType &e) {
    // 步骤1:检查删除位置合法性
    if (i < 1)
        return false;

    // 步骤2:初始化扫描指针 p 和计数器 j
    LNode *p;   // 用于扫描链表的指针
    int j = 0;  // 记录 p 当前指向的是“第几个结点”(头结点是第 0 个)
    p = L;      // p 先指向“头结点”

    // 步骤3:循环找到“第 i-1 个结点”(被删除结点的前驱结点)
    while (p != NULL && j < i-1) {
        p = p->next; // p 向后扫描
        j++;         // 计数器递增
    }

    // 步骤4:检查 i 是否合法
    if (p == NULL)
        return false; // i 超出范围,删除失败
    if (p->next == NULL)
        return false; // 第 i-1 个结点后无结点,无法删除

    // 步骤5:删除结点并释放内存
    LNode *q = p->next; // q 指向“被删除的结点”(第 i 个结点)
    e = q->data;        // 用 e 返回被删除结点的元素值
    p->next = q->next;  // 断开被删除结点(让 p 的 next 指向 q 的后继)
    free(q);            // 释放被删除结点的内存

    return true; // 删除成功
}
指定节点删除
指定节点思路与前插操作一样,因为不知道前驱节点所以将删除节点的下一个节点的数据移动到本节点然后free下一个节点
// 删除指定结点 p
bool DeleteNode(LNode *p) {
    // 如果 p 为 NULL,无法执行删除操作,返回 false
     if (p == NULL || p->next == NULL)  // p->next 不为空的判断(如果p值最后一个节点只能通过头节点遍历删除)
        return false;
    // 令 q 指向 p 的后继结点
    LNode *q = p->next;
    // 将 p 的后继结点的数据域值赋给 p 的数据域,相当于和后继结点交换数据域(实际是把后继数据放到 p 中)
    p->data = q->data;   //q->data与p->next->data等价
    // 将 q 结点从链中“断开”,使 p 的 next 指向 q 的后继结点
    p->next = q->next;
    // 释放 q 结点的存储空间
    free(q);
    // 删除操作成功,返回 true
    return true;
}
按位查找
// 按位查找,返回第 i 个元素(带头结点)
LNode *GetElem(LinkList L, int i) {
    // 如果 i 小于 0,不合法,返回 NULL
    if (i < 0)
        return NULL;
    // 指针 p 指向当前扫描到的结点
    LNode *p;
    // 当前 p 指向的是第几个结点,初始为 0(头结点是第 0 个结点,不存数据)
    int j = 0;
    // p 指向头结点
    p = L;
    // 循环找到第 i 个结点,只要 p 不为空且 j 小于 i,就继续向后扫描
    while (p != NULL && j < i) {
        p = p->next;
        j++;
    }
    // 返回找到的结点指针(若 i 超出范围,p 可能为 NULL)
    return p;
}
按值查找
// 按值查找,找到数据域等于 e 的结点
LNode *LocateElem(LinkList L, ElemType e) {
    // 从第 1 个结点开始查找数据域为 e 的结点
    LNode *p = L->next;
    // 只要 p 不为空且 p 的数据域不等于 e,就继续向后查找
    while (p != NULL && p->data != e)
        p = p->next;
    // 找到后返回该结点指针,否则返回 NULL
    return p;
}
头插法
注意头插法,插入后是你插入顺序的倒序
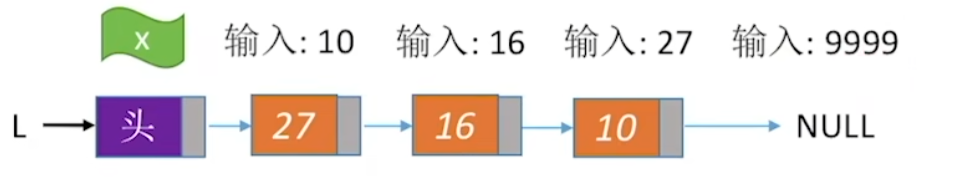
// 逆向建立单链表
LinkList List_HeadInsert(LinkList &L) {
    LNode *s;
    int x;
    // 创建头结点
    L = (LinkList)malloc(sizeof(LNode));
    // 初始为空链表,头结点的 next 指针置为 NULL
    L->next = NULL;
    // 输入结点的值
    scanf("%d", &x);
    // 输入 9999 表示结束
    while (x != 9999) {
        // 创建新结点
        s = (LNode *)malloc(sizeof(LNode));
        // 为新结点的数据域赋值
        s->data = x;
        // 新结点的 next 指针指向头结点原来的后继
        s->next = L->next;
        // 将新结点插入到表头,头结点的 next 指针指向新结点
        L->next = s;
        // 继续输入下一个结点的值
        scanf("%d", &x);
    }
    // 返回建立好的链表(头指针)
    return L;
}
尾插法
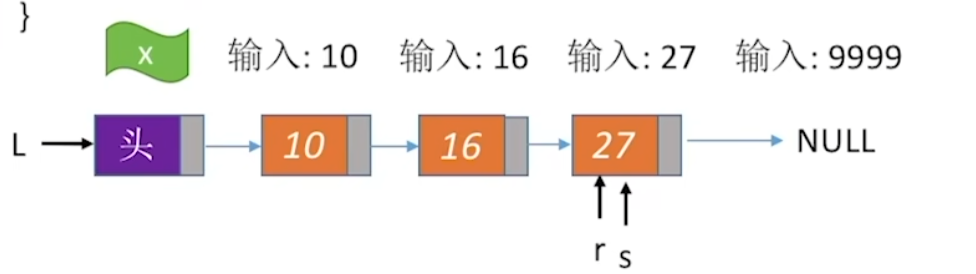
// 正向建立单链表
LinkList List_TailInsert(LinkList &L) {
    // 设 ElemType 为整型
    int x;
    // 建立头结点
    L = (LinkList)malloc(sizeof(LNode));
    // r 为表尾指针,初始指向头结点
    LNode *s, *r = L;
    // 输入结点的值
    scanf("%d", &x);
    // 输入 9999 表示结束
    while (x != 9999) {
        // 创建新结点
        s = (LNode *)malloc(sizeof(LNode));
        // 为新结点的数据域赋值
        s->data = x;
        // 将新结点连接到表尾
        r->next = s;
        // r 指向新的表尾结点
        r = s;
        // 继续输入下一个结点的值
        scanf("%d", &x);
    }
    // 尾结点指针置空
    r->next = NULL;
    // 返回建立好的链表(头指针)
    return L;
}
双链表
初始化一个双链表
// 定义双链表节点结构
typedef struct DNode {
    ElemType data;           // 数据域
    struct DNode *prior;     // 前驱指针
    struct DNode *next;      // 后继指针
} DNode, *DLinklist;

// 初始化双链表
bool InitDLinkList(DLinklist &L) {
    // 分配一个头结点
    L = (DNode *)malloc(sizeof(DNode));
    // 内存不足,分配失败
    if (L == NULL)
        return false;
    L->prior = NULL;         // 头结点的 prior 永远指向 NULL
    L->next = NULL;          // 头结点之后暂时还没有节点
    return true;
}

// 判断双链表是否为空(带头结点)
bool Empty(DLinklist L) {
    if (L->next == NULL)
        return true;
    else
        return false;
}

// 测试双链表的函数
void testDLinkList() {
    // 初始化双链表
    DLinklist L;
    InitDLinkList(L);
    // 后续代码...
}
后插操作
// 在p结点之后插入s结点
bool InsertNextDNode(DNode *p, DNode *s) {
    if (p == NULL || s == NULL)   // 非法参数
        return false;
    s->next = p->next;
    if (p->next != NULL)   // 如果p结点有后继结点
        p->next->prior = s;
    s->prior = p;
    p->next = s;
    return true;
}
删除销毁
// 删除p结点的后继结点
bool DeleteNextDNode(DNode *p) {
    if (p == NULL)
        return false;
    DNode *q = p->next;  // 找到p的后继结点q
    if (q == NULL)
        return false;  // p没有后继
    p->next = q->next;  // 将p的next指向q的next
    if (q->next != NULL)  // 如果q不是最后一个结点
        q->next->prior = p;  // 将q的后继结点的prior指向p
    free(q);  // 释放q结点的空间
    return true;
}

// 销毁双链表
void DestoryList(DLinklist &L) {
    // 循环释放各个数据结点
    while (L->next != NULL) {
        DeleteNextDNode(L);  // 每次删除头结点的后继结点
    }
    free(L);  // 释放头结点
    L = NULL;  // 头指针指向NULL
}
循环单链表
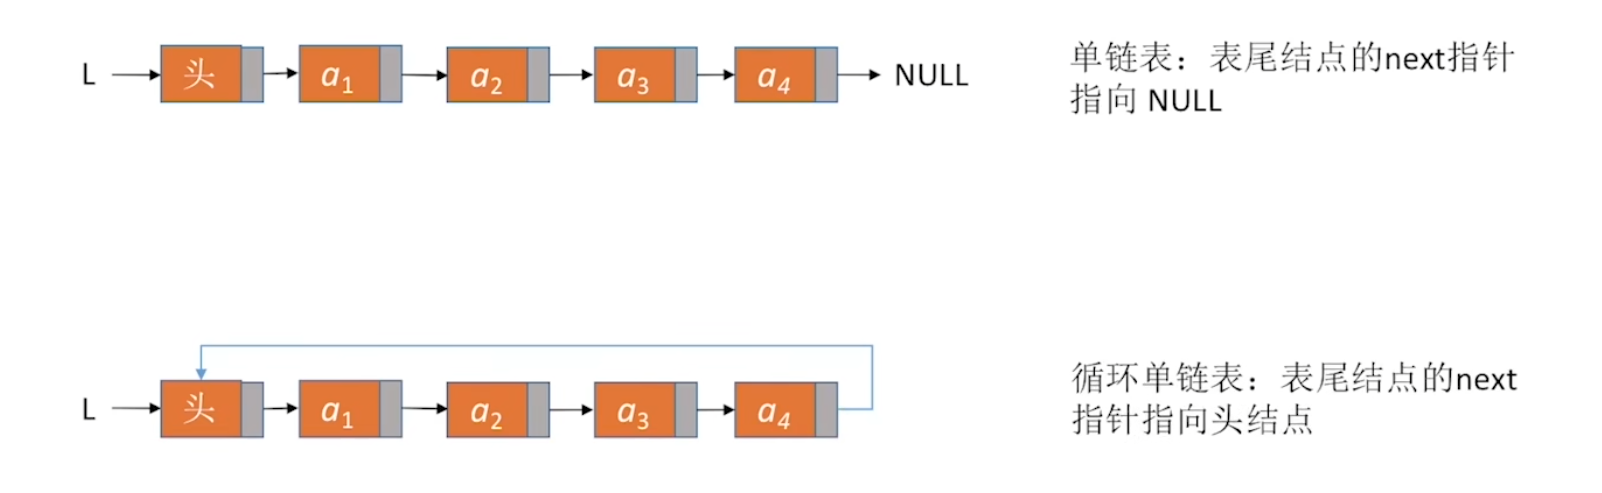
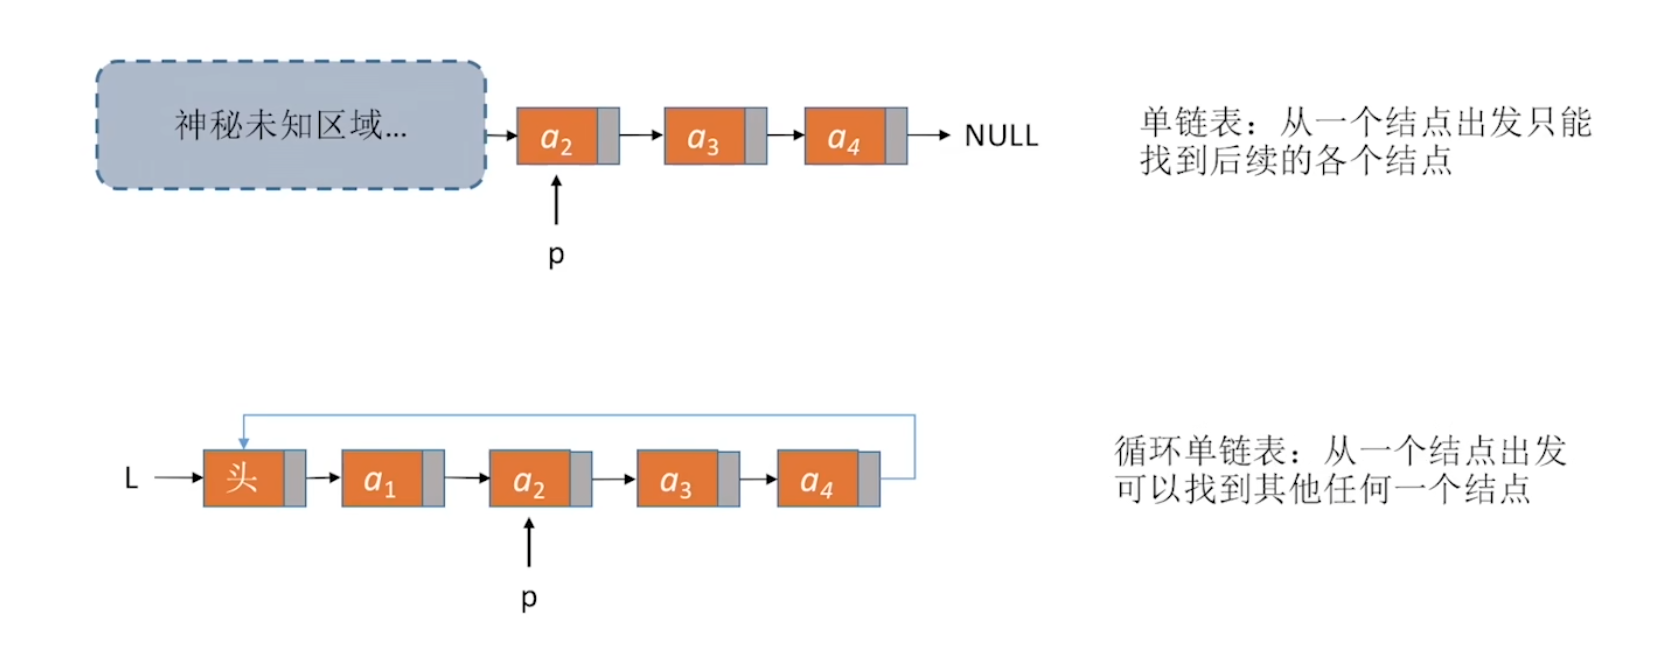
初始化循环单链表
不同的地方就在初始化时把头节点的next设置为它本身
// 定义单链表节点类型
typedef struct LNode {
    ElemType data;           // 每个节点存放一个数据元素
    struct LNode *next;      // 指针指向下一个节点
} LNode, *LinkList;

// 初始化一个循环单链表
bool InitList(LinkList &L) {
    L = (LNode *)malloc(sizeof(LNode));  // 分配一个头节点
    if (L == NULL)                       // 内存不足,分配失败
        return false;
    L->next = L;  // 头节点next指向头节点
    return true;
}

// 判断循环单链表是否为空
bool Empty(LinkList L) {
    if (L->next == L)  // 头节点的next指向自身,说明为空表
        return true;
    else
        return false;
}

//判断该节点是否为表尾节点
bool isTail(LinkList L,LNnode *p) {
    if (p->next == L)
        return true;
    else
        return false;
}
循环双链表
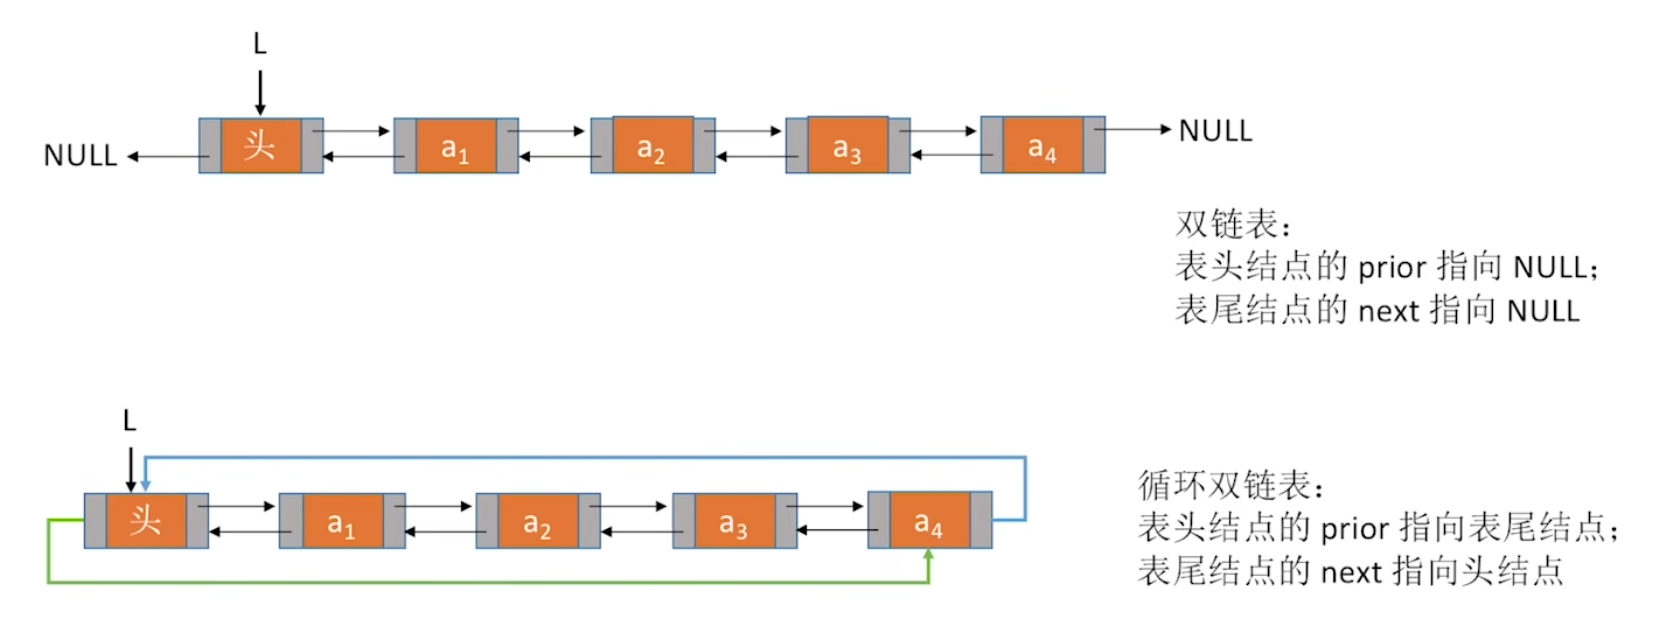
// 定义循环双链表节点结构
typedef struct DNode {
    ElemType data;           // 数据域
    struct DNode *prior;     // 前驱指针
    struct DNode *next;      // 后继指针
} DNode, *DLinklist;

// 初始化空的循环双链表
bool InitDLinkList(DLinklist &L) {
    L = (DNode *)malloc(sizeof(DNode));  // 分配一个头节点
    if (L == NULL)                       // 内存不足,分配失败
        return false;
    L->prior = L;  // 头节点的 prior 指向自身
    L->next = L;   // 头节点的 next 指向自身
    return true;
}

// 判断循环双链表是否为空
bool Empty(DLinklist L) {
    if (L->next == L)  // 头节点的 next 指向自身,即为空表
        return true;
    else
        return false;
}

// 测试循环双链表的函数
void testDLinkList() {
    // 初始化循环双链表
    DLinklist L;
    InitDLinkList(L);
    // ...后续代码...
}

// 判断节点p是否为循环双链表的表尾节点
bool isTail(DLinklist L, DNode *p) {
    if (p->next == L)  // 若p的后继指针指向头节点L,则p是表尾节点
        return true;
    else
        return false;
}
插入
插入这里就不用判断p->next是否为null了,p为最后一个节点它的next是第一个节点
// 在p结点之后插入s结点
bool InsertNextDNode(DNode *p, DNode *s) {
    s->next = p->next;       // s的后继指针指向p原来的后继节点
    p->next->prior = s;      // p原来后继节点的前驱指针指向s
    s->prior = p;            // s的前驱指针指向p
    p->next = s;             // p的后继指针指向s
}
删除
这里因为是循环,同样不需要判断q->next;
p->next = q->next;
q->next->prior = p;
free(q)
总结
链表不管是插入还是删除最终目的是让他保持链接关系
在插入表头时:
  修改L的next指向新节点以及让新节点的next指向原本L的next;让增加新节点的同时保持链接关系
  不带头节点时:
    1.需要判断是否为空链表
      如果为空直接新节点的next为null,然后将L指向新节点(L=newnode);
      如果非空则将新节点next设置为L,然后将L指向新节点;
    2.需要修改L的本身的地址
按位序插入
  带头节点:
    找到该位序的前驱节点在前驱节点之后插入节点,j = 0; j<i
    将前驱节点的next赋值给新节点next,将新节点地址本身传递给前驱节点
    将链表重新链起来
  不带头节点的如果是插入第一个节点需要修改L
前插
  后插+互换位置
静态链表

// 定义静态链表的最大长度为10
#define MaxSize 10

// 静态链表结构类型定义(第一种方式)
typedef struct {
    ElemType data;  // 存储数据元素
    int next;       // 下一个元素的数组下标(游标)
} SLinkList[MaxSize];  // SLinkList 等价于 "struct {data, next} [MaxSize]"

// 等价的定义方式(第二种方式)
struct Node {
    ElemType data;  // 存储数据元素
    int next;       // 下一个元素的数组下标(游标)
};
typedef struct Node SLinkList[MaxSize];  // 同样将 SLinkList 定义为节点数组类型


// 测试静态链表的函数(第一种定义对应的使用方式)
void testSLinkList() {
    SLinkList a;  // 定义一个静态链表a(本质是长度为10的数组)
    // ......后续代码
}

// 等价的测试函数(第二种定义对应的使用方式)
void testSLinkList() {
    struct Node a[MaxSize];  // 与 SLinkList a; 完全等价
    // ......后续代码
}
顺序表与链表